par Sasha Sutton
1 Introduction
WARC-GPT est un outil développé par le Library Innovation Lab de Harvard. Il permet d’interroger des archives web au format WARC à l’aide d’un modèle de langage. Le principe est simple. On charge un ou plusieurs fichiers WARC dans une base vectorielle, puis on pose des questions en langage naturel dans une interface de chat. Le modèle répond en s’appuyant sur des extraits de l’archive et cite ses sources.
Nous avons testé cet outil sur un fichier WARC de la BnF contenant des pages du site Marsactu entre 2011 et 2015. Cet article résume ce qui fonctionne bien et ce qui fonctionne moins bien.
2 Installation
L’installation se fait sans difficulté particulière. Nous avons créé un environnement conda avec Python 3.11, installé poetry, puis les dépendances du projet. Le modèle utilisé pour répondre aux questions est qwen2.5:3b, récupéré avec Ollama. Tout tourne en local sur une machine personnelle.
Le point faible se situe à l’étape suivante. La commande flask ingest lit le fichier WARC, découpe les pages en extraits, calcule un vecteur pour chaque extrait et stocke le tout dans une
base. Pour un fichier de 439,9 Mo, cette étape a pris douze heures. Le fichier n’est pas très gros à l’échelle d’une archive web. Sur un corpus de plusieurs gigaoctets, le temps de traitement devient
vite un obstacle.
3 Exemple de question et de réponse
Voici une des questions posées et la réponse obtenue, reproduite telle quelle. Les numéros entre crochets renvoient aux quatre extraits retournés par l’outil.
Question. Je vois que Jean-Claude Gaudin est beaucoup mentionné, que pouvez-vous me dire de lui à partir des articles mentionnant son nom ?
Réponse de ollama/qwen2.5:3b. Selon les articles mentionnant Jean-Claude Gaudin, il est un personnage politique marseillais. Il a été maire de Marseille de 1995 à 2001. Il est connu pour sa capacité d’action politique, mais aussi pour ses débats avec ses opposants, notamment sur des sujets comme la réflexion politique et la gestion de la métropole marseillaise. Il est également connu pour son lien étroit avec Patrick Mennucci, son prédécesseur en tant que maire
de Marseille. Il a également été ministre des Affaires étrangères de 2007 à 2008. Il est actuellement député de la 10ème circonscription de la Métropole du Grand Marseille.
La réponse est fluide et bien écrite. Elle commence par « selon les articles », ce qui laisse
penser que tout vient de l’archive. Nous revenons sur son contenu dans la section 5.
4 Ce qui fonctionne bien
Une fois l’ingestion terminée, l’outil est agréable à utiliser. L’interface est claire et les réponses arrivent rapidement. Sur une question générale comme « quels sont les thèmes principaux des
articles de ce corpus ? », le modèle identifie correctement que les articles traitent de politique locale marseillaise. Il cite des personnalités présentes dans le corpus, comme Jean-Claude Gaudin
ou Maryse Joissains, et donne les URL des pages d’où viennent les extraits.
Les réponses sont dans l’ensemble cohérentes avec les extraits qui leur sont fournis. Le modèle reste prudent quand il ne trouve pas ce qu’on lui demande. À la question sur les problèmes urbains, il indique d’abord qu’il n’a rien trouvé de spécifique, puis propose ce qui s’en rapproche le plus, en l’occurrence des articles sur les pistes cyclables et le Centre Bourse. Ce comportement est préférable à une réponse inventée.
Le fait que tout soit en local est aussi un avantage. Aucune donnée ne sort de la machine, ce qui compte pour des archives sous droits.
5 Ce qui fonctionne moins bien
Le premier problème concerne les sources. Quelle que soit la question, l’outil retourne exactement quatre extraits, comme le montre la Figure 1. Ce nombre est fixe. Il ne dépend ni de la
question ni de la quantité de contenu pertinent dans l’archive. Parfois les quatre extraits sont en rapport avec la question, parfois aucun ne l’est. Pour une question sur les thèmes principaux
d’un corpus de plusieurs milliers de pages, quatre extraits ne suffisent pas. La réponse ne décrit pas le corpus, elle décrit quatre pages tirées du corpus.
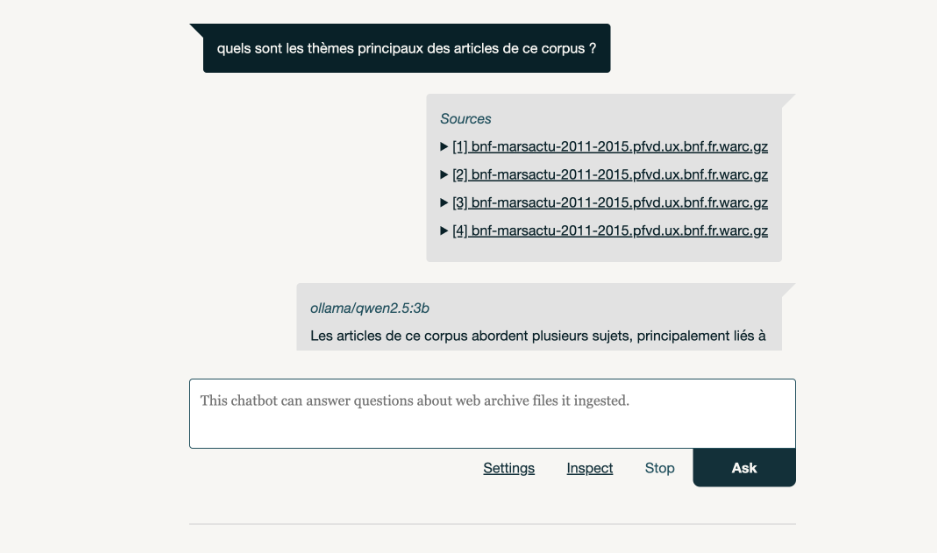
Figure 1 – Les quatre sources retournées par WARC-GPT pour une question sur les thèmes du corpus. Toutes pointent vers le même fichier WARC et il faut déplier chaque entrée pour voir l’extrait.
Le deuxième problème concerne la consultation des sources. L’interface affiche seulement l’extrait de texte qui a servi au modèle. On ne voit pas la page archivée dans son ensemble. Avec un outil comme SolrWayback, on peut ouvrir la page telle qu’elle a été capturée, avec sa mise en page et son contexte. Ici on ne dispose que d’un fragment. Il est donc difficile de vérifier si le modèle a bien compris l’extrait ou s’il a extrapolé.
Le troisième problème concerne la fiabilité du modèle. La réponse sur Jean-Claude Gaudin reproduite plus haut mélange des éléments présents dans les extraits et des affirmations fausses.
Le modèle écrit qu’il a été maire de Marseille de 1995 à 2001, ministre des Affaires étrangères de 2007 à 2008 et que Patrick Mennucci est son prédécesseur. Aucune de ces informations n’est
exacte et aucune ne vient de l’archive. Le modèle complète avec ce qu’il croit savoir, et un modèle de 3 milliards de paramètres sait peu de choses de manière fiable. Un modèle plus gros donnerait
sans doute de meilleurs résultats, mais le temps de réponse augmenterait.
6 Conclusion
WARC-GPT est un outil intéressant pour une première exploration d’une archive web. L’installation est simple, l’interface est propre et le fonctionnement en local protège les données. En revanche, l’ingestion est très lente, le nombre de sources est figé à quatre, on ne peut pas consulter les pages archivées dans leur ensemble et le modèle mélange le contenu de l’archive avec ses propres connaissances, parfois erronées. Dans l’état, il ne remplace pas un outil de recherche comme SolrWayback. Il peut le compléter pour formuler des questions ouvertes, à condition de vérifier chaque réponse dans l’archive.